3 min de lectureEnglish version
Taints et Tolerations : contrôler où tournent vos pods
Les 3 effets des Taints Kubernetes (NoSchedule, PreferNoSchedule, NoExecute), leurs cas d'usage concrets et comment les combiner avec les Tolerations.
Sommaire
Les Taints et Tolerations permettent de repousser des pods depuis certains nodes. C'est le mécanisme inverse de la Node Affinity (qui attire les pods). Les deux sont complémentaires et sont même nécessaires pour une application en production.
Le principe#
Une Taint est posée sur un node : elle signale que ce node n'accepte pas de pods par défaut. Une Toleration est déclarée dans un pod : elle lui permet de tolérer une Taint spécifique et d'être schedulé sur ce node.
Exemple de placement / retrait d'un taint:
# Appliquer une Taint sur un node
kubectl taint nodes node1 gpu=true:NoSchedule

# La retirer (tiret final obligatoire)
kubectl taint nodes node1 gpu=true:NoSchedule-
Les 3 effets#
Le taint a 3 types d'effet qu'il faut bien comprendre car chaque effet a son propre cas d'usage :
NoSchedule#
Le scheduler ne place aucun nouveau pod sur ce node s'il ne tolère pas la Taint. Les pods déjà en cours d'exécution sur le node ne sont pas affectés.
Cas d'usage : nodes GPU coûteux, nodes réservés à un workload spécifique.
PreferNoSchedule#
Le scheduler essaie d'éviter ce node, mais y placera des pods si aucune autre option n'existe.
C'est un soft constraint.
Cas d'usage : nodes en cours de maintenance progressive, nodes avec une capacité réseau réduite.
NoExecute#
Le scheduler refuse les nouveaux pods et expulse les pods existants qui ne tolèrent pas la Taint. Un tolerationSeconds peut retarder l'expulsion.
Cas d'usage : vider un node d'un coup (contrairement à kubectl drain, qui passe par l'API d'éviction et respecte les PodDisruptionBudgets), incident sur un node.
Déclarer une Toleration dans un pod#
spec:
  tolerations:
    - key: "gpu"
      operator: "Equal"
      value: "true"
      effect: "NoSchedule"
L'opérateur Exists tolère la Taint quelle que soit la valeur :
tolerations:
  - key: "gpu"
    operator: "Exists"
    effect: "NoSchedule"
Pour tolérer toutes les Taints d'un node (à éviter sauf cas très spécifiques) :
tolerations:
  - operator: "Exists"
Récapitulatif#
| Effet | Nouveaux pods | Pods existants | Contrainte |
|---|---|---|---|
NoSchedule | Bloqués | Non affectés | Stricte |
PreferNoSchedule | Évités si possible | Non affectés | Souple |
NoExecute | Bloqués | Expulsés | Stricte + rétroactive |
Cas d'usage concrets#
Nodes GPU#
kubectl taint nodes gpu-node-1 nvidia.com/gpu=true:NoSchedule
Seuls les pods déclarant la Toleration correspondante seront schedulés sur ce node. Les pods ordinaires n'y seront jamais placés, évitant de gaspiller une ressource coûteuse.
Maintenance d'un node#
Quand un node doit être retiré du service progressivement :
# Empêcher les nouveaux pods
kubectl taint nodes node1 maintenance=true:NoSchedule

# Puis drainer le node (expulse les pods existants)
kubectl drain node1 --ignore-daemonsets --delete-emptydir-data
NoExecute avec délai d'expulsion#
Utile quand on veut laisser le temps aux pods de terminer leurs traitements en cours :
tolerations:
  - key: "maintenance"
    operator: "Equal"
    value: "true"
    effect: "NoExecute"
    tolerationSeconds: 300 # Le pod aura 5 minutes avant d'être expulsé
Taints automatiques posées par Kubernetes#
AKS et Kubernetes posent automatiquement plusieurs Taints sur les nodes dans certaines situations :
| Taint | Cause |
|---|---|
node.kubernetes.io/not-ready | Node pas encore prêt |
node.kubernetes.io/unreachable | Node injoignable |
node.kubernetes.io/memory-pressure | Pression mémoire |
node.kubernetes.io/disk-pressure | Pression disque |
Les DaemonSets tolèrent généralement ces Taints par défaut pour continuer à fonctionner même sur les nodes en difficulté.
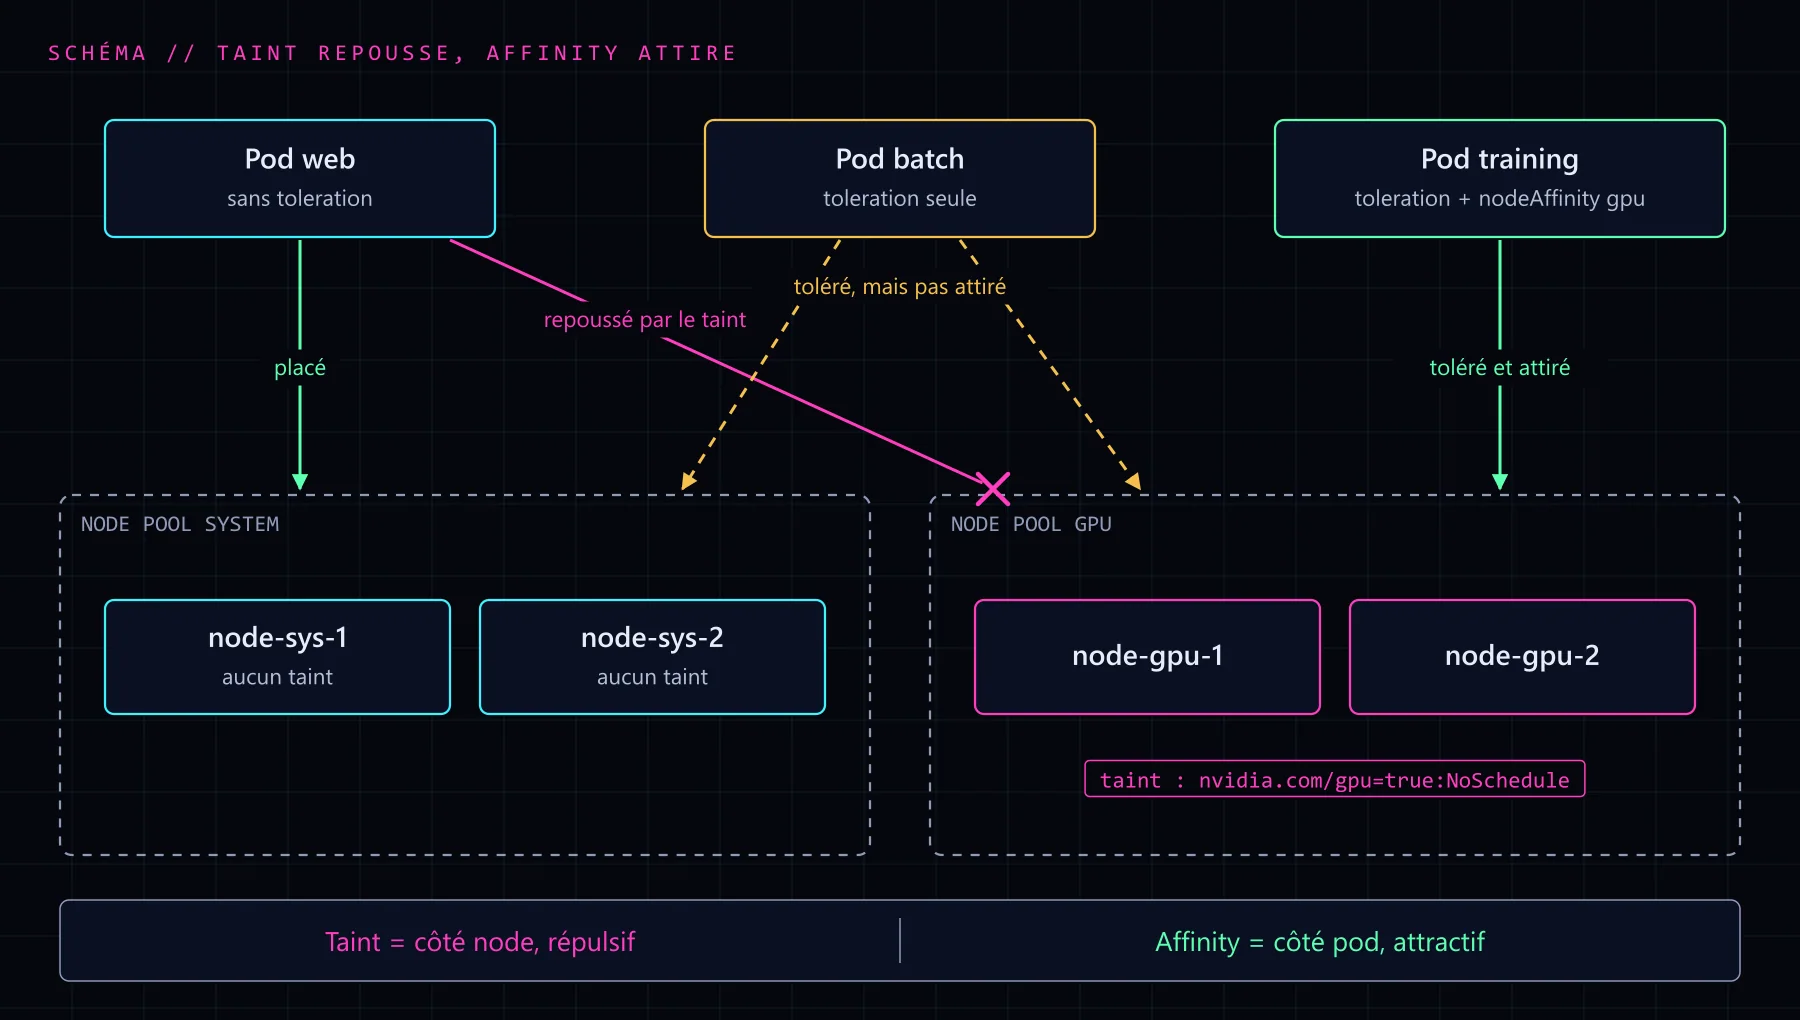
Taint vs Node Affinity#
| Mécanisme | Côté | Direction | Effet |
|---|---|---|---|
| Taint + Toleration | Node + Pod | Répulsif | Repousse les pods sans Toleration |
| Node Affinity | Pod | Attractif | Attire les pods vers certains nodes |
Les deux peuvent être combinés : Taint pour réserver un node, Node Affinity pour attirer les pods qui en ont besoin vers ce node spécifique.
Conclusion#
Les Taints et Tolerations sont un mécanisme simple en apparence mais très puissants en pratique. Ils permettent de segmenter un cluster sans multiplier les clusters : nodes GPU réservés, nodes de maintenance isolés, workloads critiques protégés des voisins bruyants. Ceci peut aussi fonctionner pour séparer vos différents blocs techniques (ex: Front/Back) mais aussi pour garantir un espace dédié au besoin.
Le point clé à retenir : une Taint sans Toleration correspondante bloque le placement, et NoExecute est le seul effet qui agit sur les pods déjà en place. Bien choisir l'effet selon que vous voulez protéger un node pour l'avenir ou le vider proprement.
En production, les Taints se combinent presque toujours avec la Node Affinity : les Taints empêchent les pods indésirables d'atterrir sur un node, la Node Affinity attire les pods voulus vers ce même node. L'un repousse, l'autre attire. Ensemble ils donnent un contrôle précis du placement sans ambiguïté et permettent de bien structurer la disposition de ses pods selon ses contraintes métier et/ou techniques.