3 min de lecture
KEDA sur AKS : scale-to-zero avec Azure Service Bus
KEDA sur AKS : installation, ScaledObject avec Azure Service Bus, comparaison avec le HPA natif, et le piège du cooldown period.
Sommaire
Le Horizontal Pod Autoscaler (HPA) natif de Kubernetes scale en fonction du CPU et de la mémoire. Mais pour un worker qui consomme des messages depuis une queue, la bonne métrique c'est la longueur de la queue — pas la charge CPU. KEDA (Kubernetes Event-Driven Autoscaling) comble exactement ce manque.
Pourquoi KEDA ?#
Le HPA natif a une limitation fondamentale : il ne peut scaler qu'en fonction de métriques de ressources (CPU, mémoire) ou de métriques custom Kubernetes. Pour des sources externes comme Azure Service Bus, Azure Storage Queue, Kafka ou Redis, il faut passer par un adapter de métriques complexe à opérer.
KEDA s'intègre directement avec ces sources externes et expose leurs métriques à Kubernetes. Il gère aussi le scale-to-zero — le HPA ne peut pas descendre à zéro réplica. Avec KEDA, un Deployment peut être complètement arrêté quand la queue est vide et redémarrer automatiquement dès qu'un message arrive.
Installation sur AKS#
KEDA est disponible comme add-on géré sur AKS :
az aks update \
  --resource-group mon-rg \
  --name mon-cluster \
  --enable-keda
Ou via Helm :
helm repo add kedacore https://kedacore.github.io/charts
helm repo update
helm install keda kedacore/keda --namespace keda --create-namespace
# Vérifier l'installation (add-on AKS : kube-system ; installation Helm : namespace keda)
kubectl get pods -n kube-system -l app=keda-operator
Configurer un ScaledObject pour Azure Service Bus#
Prérequis : authentification#
KEDA a besoin de s'authentifier auprès de Service Bus pour lire la longueur de la queue. La meilleure approche sur AKS est Workload Identity.
apiVersion: keda.sh/v1alpha1
kind: TriggerAuthentication
metadata:
  name: azure-servicebus-auth
  namespace: mon-app
spec:
  podIdentity:
    provider: azure-workload   # Utilise Workload Identity
    identityId: <client-id-de-la-managed-identity>
Attention : c'est l'opérateur KEDA qui interroge Service Bus, pas le worker. La Managed Identity doit donc être fédérée avec le service account keda-operator (dans kube-system avec l'add-on AKS), et avoir le rôle Azure Service Bus Data Owner sur le namespace Service Bus : lire le nombre de messages d'une queue demande le droit Manage, que le rôle Data Receiver n'accorde pas.
Le ScaledObject#
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: worker-scaledobject
  namespace: mon-app
spec:
  scaleTargetRef:
    name: worker-deployment       # Le Deployment à scaler
  minReplicaCount: 0              # Scale-to-zero activé
  maxReplicaCount: 20
  cooldownPeriod: 300             # 5 minutes avant de descendre à 0
  pollingInterval: 15             # Vérification toutes les 15 secondes
  triggers:
    - type: azure-servicebus
      authenticationRef:
        name: azure-servicebus-auth
      metadata:
        queueName: ma-queue
        namespace: mon-servicebus-namespace
        messageCount: "5"         # 1 replica pour 5 messages en attente
Avec messageCount: "5", KEDA créera autant de réplicas que ceil(longueur_queue / 5). Si la queue a 50 messages → 10 réplicas. Si elle se vide → scale down jusqu'à 0.
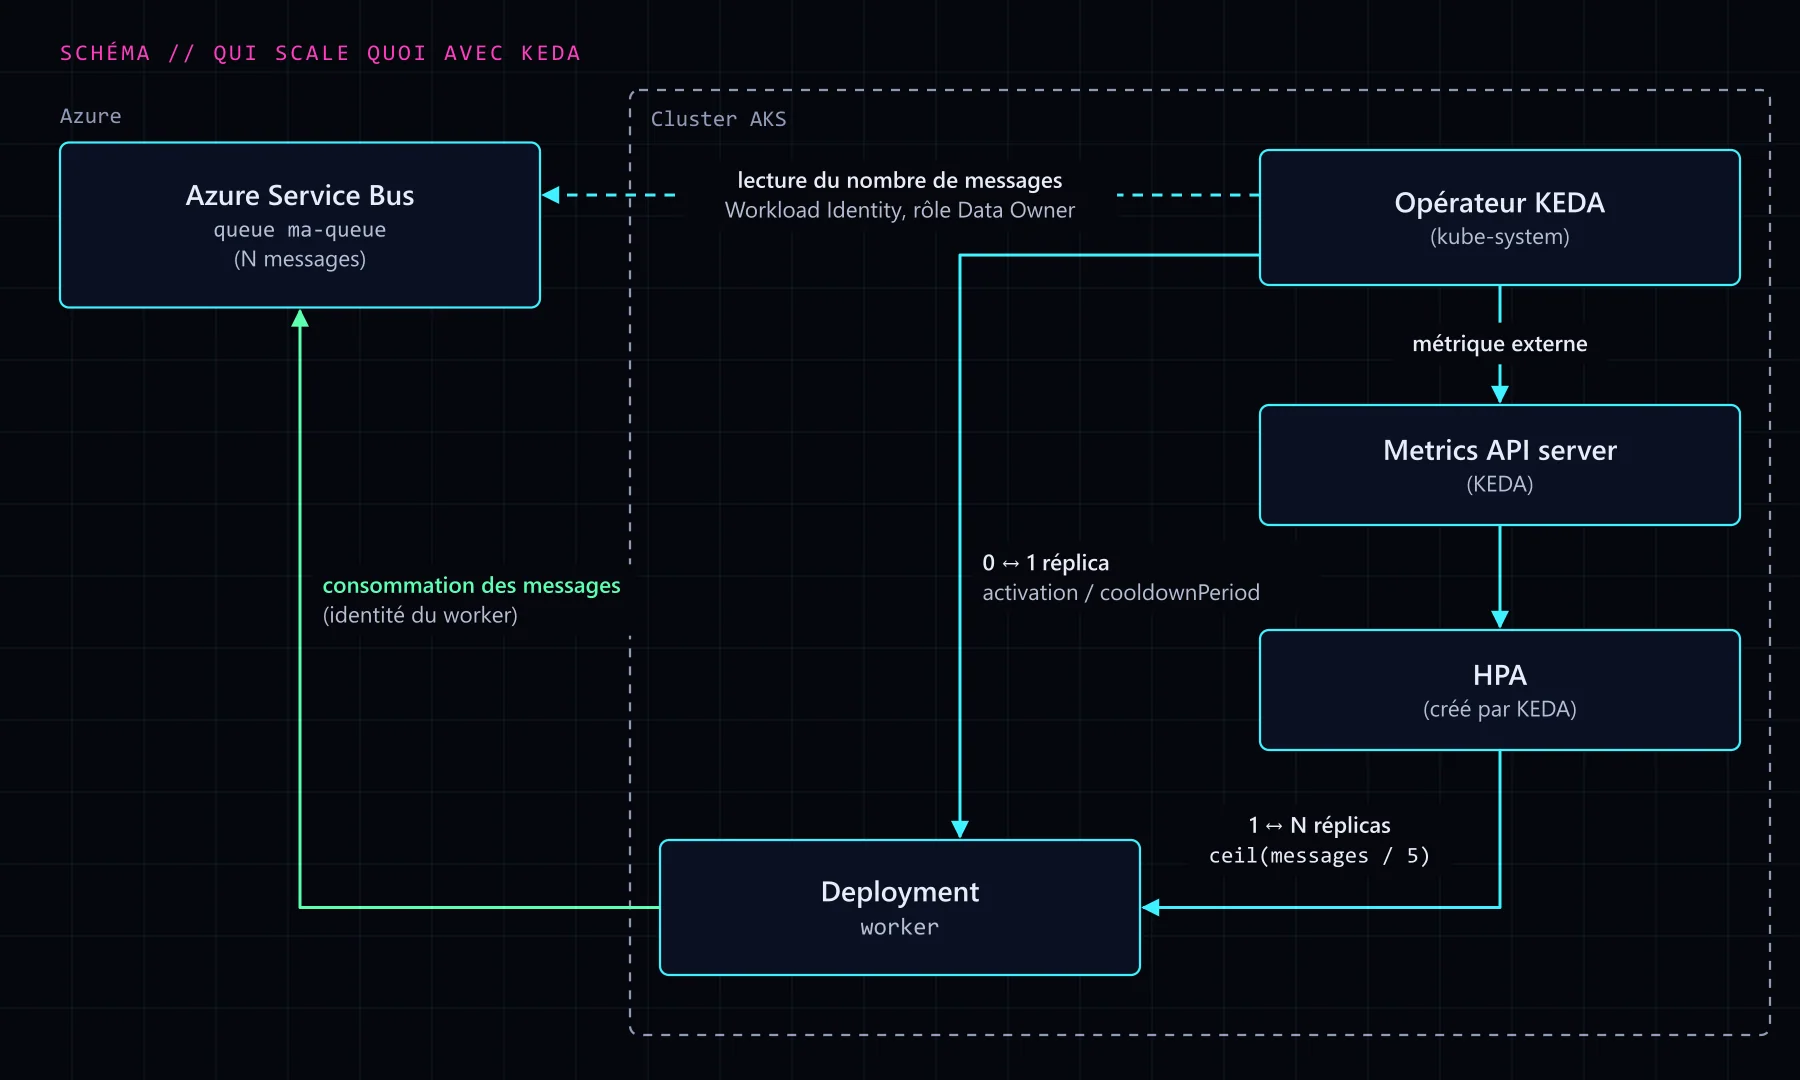
Observer le scaling en action#
# Voir l'état du ScaledObject
kubectl get scaledobject -n mon-app

# Voir les métriques KEDA
kubectl describe scaledobject worker-scaledobject -n mon-app

# Suivre le scaling en temps réel
kubectl get pods -n mon-app --watch
Comparaison avec le HPA natif#
| Critère | HPA natif | KEDA |
|---|---|---|
| Métriques sources | CPU, mémoire, custom K8s | +50 sources externes (Azure, AWS, GCP, Kafka...) |
| Scale-to-zero | Non (minimum 1) | Oui |
| Latence scale-out | ~1 minute | ~15-30 secondes (configurable) |
| Complexité | Faible | Faible à moyenne |
| Overhead | Aucun | Léger (pods KEDA dans le cluster) |
Le piège du cooldown#
Le cooldownPeriod est exprimé en secondes et représente le temps minimum que KEDA attend après que la queue soit vide avant de descendre les réplicas à minReplicaCount.
Un cooldown trop court (< 60s) peut créer un effet ping-pong : la queue se vide, KEDA scale-down, de nouveaux messages arrivent, KEDA scale-up à nouveau — rapidement et continuellement. Chaque cold start d'un pod coûte du temps de traitement.
Un cooldown trop long (> 10 min) signifie que des pods tournent à vide pendant longtemps après que la queue soit traitée.
La valeur dépend du rythme de production de messages et du temps de démarrage du pod. Pour un worker avec un cold start de 10-15 secondes et une queue qui reçoit des messages toutes les quelques minutes, 120-300 secondes est souvent un bon compromis.
Scale-to-zero et les premiers messages#
Quand minReplicaCount: 0, il n'y a aucun pod pour traiter les messages quand la queue se remplit à nouveau. KEDA détecte des messages dans la queue, crée un premier pod, et ce pod commence à traiter. Le premier message peut donc attendre le temps de démarrage du pod (cold start).
Si la latence du premier message est critique, garder minReplicaCount: 1 — on perd le bénéfice du scale-to-zero mais le premier message est traité immédiatement.